Escalabilidade e Confiabilidade de Plataformas de Cassino
Escalabilidade de plataformas de cassino não significa apenas carregar a página inicial para mais visitantes. Uma promoção pode aumentar ao mesmo tempo acessos, sessões de jogo, chamadas aos provedores, operações de carteira e callbacks. Cada fluxo exige níveis distintos de latência e consistência. Adicionar servidores de aplicação pode aliviar a API, mas sobrecarregar um banco de dados compartilhado, um parceiro de pagamento ou o armazenamento de sessões. A confiabilidade traz outra pergunta: se uma dependência falhar, os saldos e resultados continuarão corretos, a situação ficará clara para o jogador e a recuperação ocorrerá dentro das metas definidas? Este guia relaciona capacidade a jornadas reais de cassino, explica o alcance e as limitações da redundância e apresenta critérios de aceitação verificáveis. As fontes técnicas descrevem métodos de arquitetura; não comprovam o desempenho nem os SLA de qualquer plataforma específica. [1] [2] [3] [6]
Publicado em
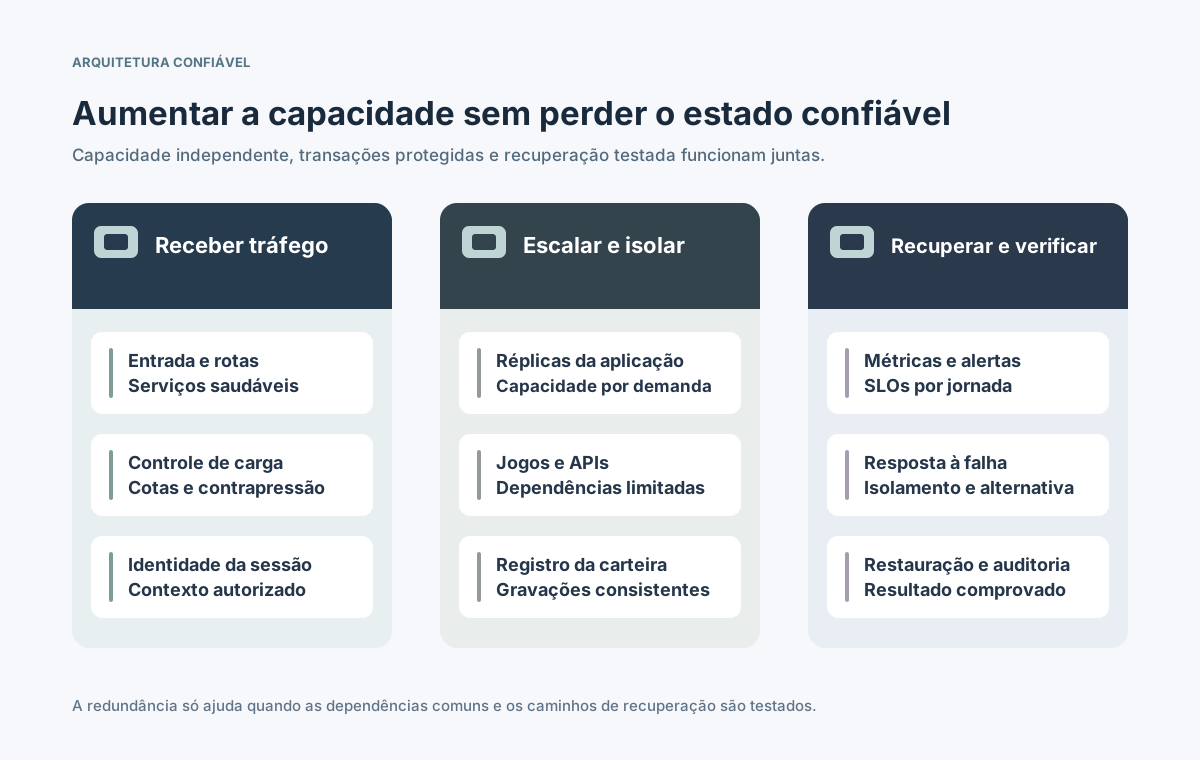
Capacidade confiável depende de serviços independentes, estado protegido e recuperação comprovada, não apenas da quantidade de servidores.
Neste artigo
O que são escalabilidade e confiabilidade em uma plataforma de cassino?
Escalabilidade é manter serviço aceitável quando a demanda muda. Confiabilidade significa executar as funções de maneira correta e constante, inclusive após falhas. Um catálogo rápido pode coexistir com erros de saldo ou de lançamento de jogos. Defina critérios distintos para descoberta, login, sessão ativa, pagamentos e operações administrativas. [1] [2]
Capacidade e resiliência se relacionam, mas não são sinônimos. Mais servidores web não recuperam um banco único de carteira, e várias regiões não impedem automaticamente callbacks duplicados. Identifique estado crítico, dependências e interrupções aceitáveis em cada jornada antes de escolher a infraestrutura. [1] [6]
Quais componentes chegam primeiro ao limite com o aumento do tráfego?
Uma solicitação pode atravessar borda, API, sessão, provedor de jogos, carteira, banco de dados e fila de eventos. Cada componente possui um teto. Os testes devem reproduzir jornadas completas e registrar espera, erros e saturação por dependência. A velocidade da página inicial não demonstra capacidade transacional. [1] [5]
Componente
Sinal de pressão
O que validar
Borda e lobby
Pico de acessos
Cache, controle de taxa, origem
Login e sessões
Entradas simultâneas
Armazenamento e continuidade
API de lançamento
Latência do provedor
Timeouts, cotas e tokens
Carteira e razão
Gravações concorrentes
Bloqueios e conciliação
Pagamentos e KYC
Serviço externo lento
Filas e status pendente
Eventos e relatórios
Acúmulo de callbacks
Atraso e repetição
Separe sessões simultâneas, transações por segundo e limites de terceiros. Solicite resultados medidos nos pontos reais de integração em vez de interpretar uma capacidade comercial divulgada como garantia financeira. [1] [5]
Como aumentar a capacidade da aplicação sem perder sessões?
Serviços web e APIs sem estado podem crescer horizontalmente atrás de um balanceador com verificação de saúde. O Kubernetes documenta o HorizontalPodAutoscaler para ajustar réplicas por métricas, mas isso não elimina gargalos do banco nem limites de parceiros. Selecione indicadores que representem filas e latência percebida. [3]
Manter sessões de conta e estado crítico fora de processos substituíveis da aplicação.
Definir pedidos de recursos, limites de réplicas e aquecimento a partir de testes reais.
Aplicar contrapressão quando provedores de jogos, pagamentos ou verificação chegam perto das cotas.
Testar a reação da escala automática a picos, crescimento gradual e redução de carga.
Lobby, gateway de lançamento e trabalhadores assíncronos podem ter políticas diferentes. Se uma dependência não consegue acompanhar a demanda, uma recusa controlada e explicada é mais segura que tentativas infinitas que ampliam o incidente. [1] [3]
Que redundância protege a jornada de um jogo em andamento?
A redundância depende dos domínios de falha: host, zona, rede ou provedor externo podem cair isoladamente. Distribua instâncias críticas, verifique prontidão real e especifique o destino de um jogo ou pagamento em andamento durante failover. Várias cópias da aplicação não substituem testes de consistência e repetição. [1] [6]
Relacionar cada jornada crítica aos serviços e provedores de que realmente depende.
Isolar cargas para que um parceiro lento ou relatório pesado não esgote recursos compartilhados.
Definir health checks, circuit breakers, limites de espera e alternativas seguras.
Simular falhas de nó, serviço e parceiro, comparando o resultado às metas acordadas.
⊕Ampliar diagramaRedundância eficaz combina roteamento, isolamento, dados confiáveis e evidências de restauração.
O failover pode preservar parte das funções e suspender outras. Documente ações somente de leitura, bloqueadas ou enfileiradas. Um segundo servidor respondendo não comprova a integridade das transações financeiras. [1] [6]
Por que sessões de jogo e operações de carteira precisam escalar de modo diferente?
O catálogo frequentemente tolera cache, mas saldos em dinheiro real e resultados de apostas exigem ordem e consistência autoritativas. Mesmo com requisições distribuídas entre réplicas, o sistema transacional deve impedir dois débitos sobre os mesmos fundos ou o registro duplicado de um resultado. Isso exige lógica de negócio, não apenas autoscaling. [1] [4]
Operação
Padrão seguro
Condição correta
Encontrar jogo
Cache com validade
Elegibilidade do mercado atualizada
Iniciar sessão
Token autorizado de curta duração
Jogador e contexto corretos
Aposta e liquidação
Gravação idempotente
Sem débito ou liquidação duplicados
Consultar saldo
Valor do servidor
Pendências tratadas claramente
Retomar sessão
Revalidar e conciliar
Sem estado de jogo órfão
Associe identificador da solicitação, referência do provedor, lançamento durável no razão e status final. Um callback atrasado não pode substituir um resultado posterior confirmado; o contrato deve prever conciliação ou investigação manual. [4] [5]
Como filas e novas tentativas evitam movimentações duplicadas?
Filas desacoplam serviços, mas não garantem uma ordem perfeita. A AWS documenta entrega pelo menos uma vez e mensagens possivelmente fora de sequência nas filas SQS padrão. A regra geral é projetar consumidores para processar callbacks e mensagens repetidos com segurança. [4]
Atribuir chaves estáveis de idempotência às operações financeiras e guardar o resultado de modo durável.
Limitar retentativas, adotar espera crescente e caminho de investigação para mensagens problemáticas.
Diferenciar respostas de provedores atrasadas, ausentes ou conflitantes antes de alterar o saldo.
Conciliar registros dos provedores com o razão interno e alertar sobre divergências abertas.
O processamento assíncrono exige estados visíveis: pendente, concluído, falhou e em disputa. A prevenção de duplicidade precisa existir no ponto autoritativo de escrita; a repetição devolve o resultado anterior, sem criar outro débito. [4] [7]
Que decisões de banco de dados e armazenamento afetam a confiabilidade?
Réplicas de leitura e caches podem acelerar consultas não críticas, mas atrasar em relação a gravações. Separe os dados que exigem consistência imediata daqueles que toleram alguma defasagem e dos que precisam sobreviver à falha de zona ou região. Replicação e particionamento devem seguir padrões medidos e testes de falha. [1] [6]
Área de dados
Risco típico
Evidência solicitada
Razão da carteira
Escritas concorrentes
Isolamento e restauração
Identidade
Revogação de sessão
Logout em todas as instâncias
Catálogo
Cache desatualizado
Propagação de mudança de mercado
Histórico de eventos
Repetição e auditoria
Ordem e retenção
Backups
Ponto recuperável
Teste de restauração e integridade
Backup, restauração até um ponto no tempo e failover precisam de testes separados. RPO e RTO são escolhas do negócio; uma cópia nunca restaurada não prova que esses objetivos podem ser cumpridos. [6]
Como medir confiabilidade com SLOs e telemetria?
O indicador SLI mede a experiência observada; o SLO fixa a meta aceitável. O Google SRE recomenda indicadores úteis e orçamentos de erro, em vez de promessas vagas de disponibilidade perfeita. Uma porcentagem global pode esconder falhas de carteira ou lançamento de jogos. [2]
Definir sucesso e latência separados para login, lançamento, gravação da carteira e pagamento.
Monitorar volume, erros, latência e saturação na entrada e em cada dependência.
Correlacionar traces, métricas e logs de APIs, filas e provedores usando referências seguras.
Alertar sobre impacto ao jogador, liquidações paradas e atraso de conciliação com responsáveis definidos.
OpenTelemetry descreve sinais de telemetria, e o Google apresenta os quatro sinais essenciais. Evite enviar dados pessoais ou de pagamento para registros de diagnóstico; aplique restrições de acesso e retenção. [5] [7]
O que incluir na recuperação de desastres e na implantação segura?
Manter funções após a falha de um componente difere de recuperar tudo após um incidente maior. Defina objetivo de tempo de recuperação RTO e perda aceitável de dados RPO para jornadas críticas, escolhendo uma estratégia comprovável. A AWS descreve esses valores como metas mensuráveis, não garantias universais. [6]
Guardar backups versionados e comprovar restauração e integridade em exercícios.
Documentar infraestrutura, segredos, dependências e responsáveis pela recuperação.
Implantar mudanças gradualmente com health gates, reversão e compatibilidade de sessões.
Testar perda de zona ou serviço central sem repetir de forma ambígua movimentos financeiros.
Comunicar limitações temporárias e próximas ações aos jogadores e ao suporte.
O procedimento deve identificar o líder do incidente, a decisão de pausar novas transações, a ordem de restauração e a conciliação posterior. Refaça os exercícios após mudanças importantes; um comando de backup não é um plano completo. [1] [6]
Que testes exigir antes de aprovar uma plataforma?
Uma aceitação séria combina cargas representativas, falhas específicas e validação dos resultados financeiros. Solicite metodologia de teste, limites de parceiros, alertas, escalonamento e evidência de recuperação. Números de outra infraestrutura, país ou conjunto de provedores não são garantia contratual. [1] [2]
Testar pico e rajadas com mistura realista de login, lobby, jogos e carteira.
Simular timeout do provedor, callbacks perdidos ou duplicados e saturação temporária do banco.
Verificar ausência de débitos duplicados, liquidações perdidas e crescimento ilimitado da fila.
Medir SLO, RTO, RPO e mensagens ao usuário durante implantação e recuperação.
Registrar limites de aceitação, responsáveis, dependências externas e riscos restantes.
O objetivo não é ter mais servidores nem divulgar uma taxa genérica de uptime. É crescer mantendo saldos corretos, resultados previsíveis e recuperação testada dos processos importantes para a operação. [1] [4] [6]