Skalierbarkeit und Zuverlässigkeit von Casino-Plattformen
Die Skalierbarkeit einer Casino-Plattform lässt sich nicht an der Geschwindigkeit ihrer Startseite messen. Eine Werbeaktion erhöht gleichzeitig die Zahl der Anmeldungen, Spielesitzungen, Provider-Aufrufe, Wallet-Vorgänge und Rückmeldungen. Diese Prozesse haben unterschiedliche Anforderungen an Antwortzeiten und Datenkonsistenz. Mehr Anwendungsserver können die API entlasten und gleichzeitig eine gemeinsame Datenbank, den Zahlungsdienst oder den Sitzungsspeicher überfordern. Zuverlässigkeit stellt die ergänzende Frage: Bleiben Konten und Transaktionen bei Ausfällen korrekt, erhalten Nutzer verständliche Informationen und gelingt die Wiederherstellung innerhalb definierter Ziele? Dieser Leitfaden verbindet Kapazitätsplanung mit konkreten Casino-Abläufen, erläutert Grenzen der Redundanz und formuliert prüfbare Abnahmekriterien. Die technischen Quellen beschreiben Architekturverfahren, bestätigen aber keine bestimmten Anbieterleistungen oder SLA-Zusagen. [1] [2] [3] [6]
Veröffentlicht
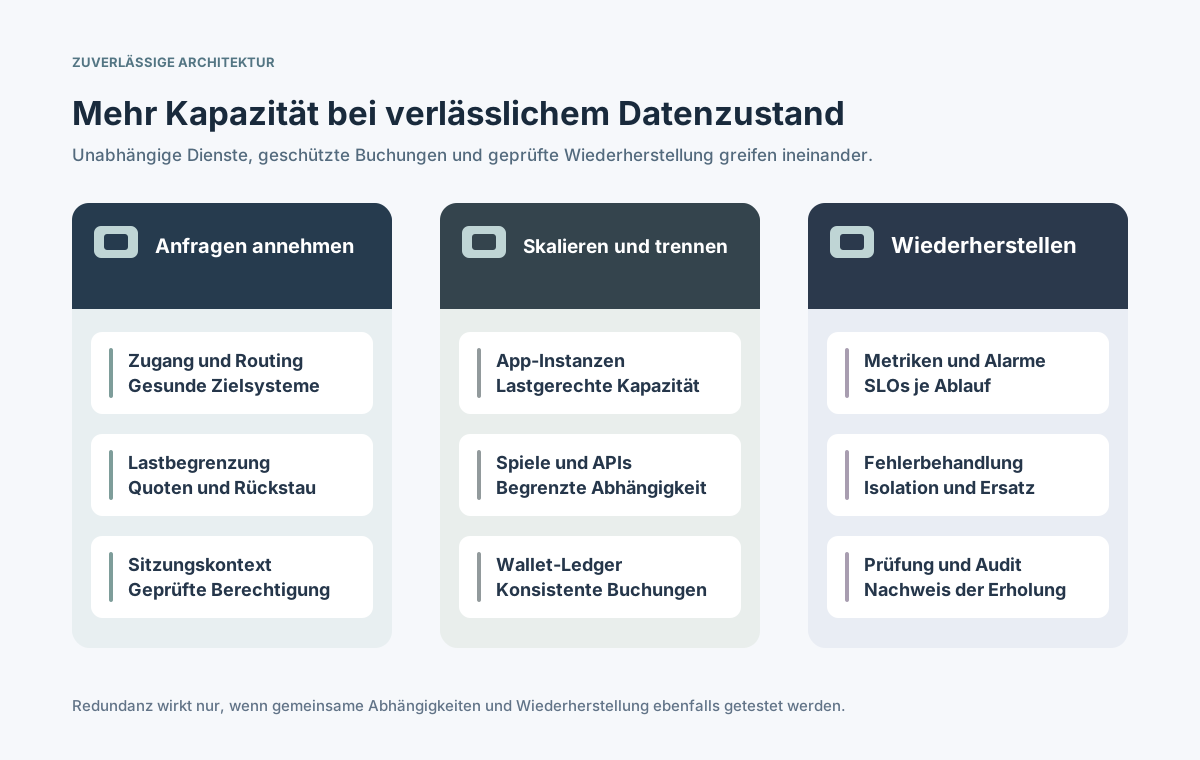
Verlässliche Kapazität entsteht durch unabhängige Dienste, geschützte Zustände und erprobte Wiederherstellung.
Inhalt
Was bedeuten Skalierbarkeit und Zuverlässigkeit bei Casino-Plattformen?
Skalierbarkeit beschreibt eine angemessene Leistung bei veränderlicher Nachfrage; Zuverlässigkeit die korrekte, beständige Ausführung einschließlich der Erholung nach Störungen. Ein schneller Spielkatalog nützt wenig, wenn eine Balance-Abfrage oder der Spielstart ausfällt. Definieren Sie Erfolg getrennt für Anmeldung, Spielsuche, laufende Spiele, Zahlungen und Backoffice. [1] [2]
Kapazität und Resilienz sind verwandt, aber nicht identisch. Zusätzliche Webserver beheben keinen Ausfall der einzigen Wallet-Datenbank; mehrere Regionen verhindern nicht automatisch doppelte Provider-Callbacks. Kritische Zustände, Abhängigkeiten und tolerierbare Unterbrechungen müssen vor der Technologiewahl feststehen. [1] [6]
Welche Komponenten erreichen unter Last zuerst ihre Grenzen?
Eine Aktion durchläuft möglicherweise Gateway, API, Sitzungsdienst, Spielanbieter, Wallet, Datenbank und Ereignisverarbeitung. Jede Station hat eine eigene Obergrenze. Lasttests sollten vollständige Nutzerwege abbilden und Verzögerungen, Fehlerraten sowie Auslastung je Abhängigkeit dokumentieren; eine schnelle Landingpage beweist keine Skalierung. [1] [5]
Komponente
Belastungszeichen
Prüfung
Edge und Lobby
Plötzliche Anfragen
Cache, Limits, Ursprungskapazität
Login und Sitzungen
Viele parallele Logins
Sitzungsspeicher und Kontinuität
Spielstart-API
Wartezeit beim Anbieter
Timeouts, Quoten, Start-Token
Wallet und Ledger
Konkurrierende Buchungen
Sperren und Abstimmung
Zahlungen und KYC
Langsame Fremddienste
Queues und Pending-Status
Events und Berichte
Callback-Rückstau
Verzögerung und Wiederholung
Gleichzeitige Sitzungen, Transaktionen pro Sekunde und externe Ratenlimits sind verschiedene Größen. Verlangen Sie gemessene Werte am relevanten Integrationspunkt, statt aus beworbenen Nutzerzahlen eine garantierte Zahlungsrate abzuleiten. [1] [5]
Wie lässt sich Anwendungskapazität ohne Sitzungsbrüche erhöhen?
Zustandslose Web- und API-Worker eignen sich für horizontale Skalierung hinter einem Load Balancer mit Gesundheitsprüfung. Kubernetes dokumentiert die automatische Anpassung der Replikenzahl mit HorizontalPodAutoscaler. Das ersetzt jedoch weder Engpassanalysen der Datenbank noch die Grenzen externer Anbieter. Die Metrik muss Warteschlangen und Nutzerlatenz abbilden. [3]
Kontositzungen und kritische Zustände außerhalb kurzlebiger Anwendungsinstanzen speichern.
Ressourcenanforderungen, Replikengrenzen und Anlaufzeit anhand von Tests festlegen.
Bei Provider-Quoten für Spiele, Zahlungen oder Prüfungen eine wirksame Lastbegrenzung einsetzen.
Autoskalierung bei Lastspitzen, allmählichem Wachstum und Abskalierung praktisch testen.
Lobby, Start-Gateway und Hintergrundverarbeitung benötigen womöglich getrennte Kapazitätsregeln. Kann ein Fremddienst nicht mithalten, ist eine kontrollierte Fehlermeldung sicherer als grenzenlose Wiederholungen, die die Störung verstärken. [1] [3]
Welche Redundanz schützt einen laufenden Spielvorgang?
Redundanz muss Ausfallbereiche berücksichtigen: Server, Verfügbarkeitszone, Netzwerk oder Fremdanbieter können separat ausfallen. Verteilen Sie kritische Instanzen, messen Sie die tatsächliche Betriebsbereitschaft und definieren Sie das Verhalten offener Spiel- und Zahlungsabläufe beim Umschalten. Mehrere App-Instanzen ersetzen keine Tests zu Datenbesitz und Ereigniswiederholung. [1] [6]
Für jeden kritischen Nutzerweg die wirklich benötigten Komponenten und Partner auflisten.
Lasten isolieren, damit ein langsamer Anbieter oder Bericht nicht alle Ressourcen verbraucht.
Health Checks, Circuit Breaker, Wartezeitgrenzen und sichere Alternativen spezifizieren.
Ausfall von Knoten, Dienst und Abhängigkeit simulieren und das Ziel mit Messwerten vergleichen.
Beim Failover kann eine Teilfunktion weiterlaufen, während andere Funktionen deaktiviert sind. Legen Sie explizit fest, welche Aktionen nur lesbar, gesperrt oder zwischengespeichert sind. Ein zweiter antwortender Webserver garantiert noch keine Geldkonsistenz. [1] [6]
Warum brauchen Spielesitzungen und Wallet-Vorgänge verschiedene Skalierungsmuster?
Spielekataloge vertragen häufig Caches; Echtgeldsaldo und Einsatzabrechnung benötigen dagegen eine verbindliche Reihenfolge und Konsistenz. Auch wenn Anfragen verschiedene App-Replikate erreichen, muss der Transaktionsdienst doppeltes Abbuchen oder erneutes Verbuchen desselben Ergebnisses verhindern. Diese fachliche Korrektheit entsteht nicht durch Autoskalierung. [1] [4]
Vorgang
Sicheres Muster
Korrektheitsbedingung
Spiele finden
Cache mit Ablaufzeit
Markt- und Providerfreigabe aktuell
Spiel starten
Kurzlebiges Autorisierungs-Token
Gültiger Spieler- und Spielkontext
Einsatz abrechnen
Idempotente Ledger-Buchung
Keine doppelte Belastung
Saldo anzeigen
Verbindlicher Serverwert
Offene Buchungen berücksichtigt
Sitzung fortsetzen
Erneute Prüfung und Abgleich
Kein verwaister Spielzustand
Verknüpfen Sie Anfrage-ID, Provider-Korrelation, dauerhafte Ledger-Buchung und Endstatus. Späte Callbacks dürfen ein bestätigtes neueres Ergebnis nicht überschreiben; der Vertrag muss Abstimmung oder manuelle Prüfung vorsehen. [4] [5]
Wie helfen Queues und Wiederholungen ohne doppelte Geldbewegungen?
Nachrichtenwarteschlangen entkoppeln Dienste, garantieren aber nicht automatisch die Reihenfolge. AWS dokumentiert mindestens einmalige sowie potenziell ungeordnete Zustellung in Standard-SQS-Queues. Allgemein gilt: Verbraucher müssen doppelte Nachrichten und wiederholte Callbacks sicher verarbeiten. [4]
Finanzvorgängen stabile Idempotenzschlüssel zuweisen und Ergebnisse dauerhaft speichern.
Wiederholungen begrenzen, exponentielles Backoff und einen Untersuchungsweg vorsehen.
Verspätete, ausbleibende oder widersprüchliche Provider-Antworten unterscheiden.
Provider-Daten regelmäßig mit internen Buchungen abgleichen und Differenzen melden.
Asynchrone Abläufe brauchen sichtbare Zustände für ausstehend, erfolgreich, fehlgeschlagen und strittig. Die Idempotenzprüfung gehört an die verbindliche Buchungsgrenze: Eine Nachricht darf bei erneuter Zustellung kein zweites Debit auslösen. [4] [7]
Welche Datenbank- und Speicherentscheidungen bestimmen die Zuverlässigkeit?
Lesereplikate und Caches beschleunigen unkritische Abfragen, können aber hinter Schreibvorgängen zurückliegen. Trennen Sie strikt konsistente Daten von Informationen, bei denen veraltete Werte tolerierbar sind. Replikation oder Partitionierung müssen zu gemessenen Transaktionen und Ausfalltests passen; eine Datenbankkopie macht das Gesamtsystem nicht automatisch sicher. [1] [6]
Datenbereich
Typisches Risiko
Benötigter Nachweis
Wallet-Ledger
Parallele Schreibzugriffe
Isolation und Restore-Test
Spieleridentität
Sitzungsentzug
Logout über alle Instanzen
Spielekatalog
Veraltete Cache-Daten
Verteilung von Marktänderungen
Ereignishistorie
Wiederholung und Audit
Reihenfolge und Aufbewahrung
Backups
Verwertbarer Sicherungspunkt
Restore-Probe und Integritätskontrolle
Datensicherung, zeitpunktgenaue Wiederherstellung und Failover müssen separat geprüft werden. RPO und RTO sind geschäftliche Zielwerte; ein niemals zurückgespieltes Backup belegt nicht, dass sie eingehalten werden können. [6]
Wie messen Betreiber Zuverlässigkeit mit SLOs und Telemetrie?
Service Level Indicators messen die tatsächliche Nutzererfahrung; Service Level Objectives setzen Zielwerte. Google SRE empfiehlt aussagekräftige Indikatoren und Fehlerbudgets statt undefinierter Versprechen vollständiger Betriebszeit. Ein einziger Verfügbarkeitswert kann fehlgeschlagene Wallet- oder Spielstarts verbergen. [2]
Erfolg und Latenz für Login, Spielstart, Wallet-Schreibvorgänge und Zahlungen getrennt bewerten.
Traffic, Fehler, Latenz und Sättigung sowohl am Eingang als auch bei Abhängigkeiten beobachten.
Traces, Metriken und Logs über APIs, Queues und Anbieter mit sicheren Kennungen verbinden.
Bei Nutzerbeeinträchtigung, offenen Abrechnungen und Abgleichverzug alarmieren; Zuständigkeiten festlegen.
OpenTelemetry beschreibt die Signale der Beobachtbarkeit, Google die vier grundlegenden Monitoring-Signale. Vertrauliche Spieler- oder Zahlungsdaten gehören nicht ungeschützt in Diagnoselogs; Zugriff und Speicherdauer sind zu begrenzen. [5] [7]
Was gehören zu Disaster Recovery und sicheren Releases?
Der Ausfall einzelner Komponenten ist etwas anderes als ein schwerer Standort- oder Datenvorfall. Definieren Sie Wiederherstellungszeit RTO und zulässigen Datenverlust RPO für zentrale Prozesse und wählen Sie eine nachweislich passende Strategie. AWS beschreibt diese Werte als messbare Ziele, nicht als allgemeingültige Garantien. [6]
Versionierte Backups erstellen und deren Wiederherstellung mit Integritätsprüfung üben.
Infrastruktur, Geheimnisse, Abhängigkeiten und zuständige Personen dokumentieren.
Änderungen gestuft ausrollen, Health Gates und Rollback für aktive Sitzungen testen.
Zonen- oder Serviceausfälle ohne uneindeutige Wiederholung von Wallet-Buchungen simulieren.
Nutzern und Support Einschränkungen und nächste Schritte verständlich mitteilen.
Ein Runbook braucht Incident-Leitung, Regeln zum Stoppen neuer Finanzaktionen, Ablauf der Wiederherstellung und nachträglichen Abgleich. Nach wesentlichen Änderungen erneut testen; ein bekannter Backup-Befehl allein ist kein Notfallplan. [1] [6]
Was sollten Käufer und Teams vor der Plattformabnahme testen?
Ein Abnahmetest verbindet realistische Last mit gezielten Ausfällen und korrekten Finanzresultaten. Lassen Sie sich Methodik, Anbieterquoten, Warnsignale, Eskalationswege und Wiederherstellungsnachweise vorlegen. Ein Benchmark mit anderer Infrastruktur oder anderen Märkten ist keine vertragliche Leistungsgarantie. [1] [2]
Spitzen und Laststöße mit realistischem Mix aus Logins, Lobby, Spielen und Wallet prüfen.
Provider-Timeouts, verlorene und doppelte Callbacks sowie Datenbanksättigung simulieren.
Doppelte Belastungen, fehlende Abrechnungen und unbegrenzte Queue-Länge ausschließen.
SLO, RTO, RPO und für Nutzer sichtbare Zustände beim Rollout und Recovery messen.
Abnahmeschwellen, Verantwortliche, Fremdabhängigkeiten und Restrisiken festhalten.
Das Ziel ist weder die höchste Serverzahl noch eine pauschale Uptime-Prozentzahl, sondern kontrolliertes Wachstum mit richtigen Salden, verständlichen Ergebnissen und nachgewiesener Wiederherstellung der wichtigsten Nutzerabläufe. [1] [4] [6]