Skalabilitas platform kasino bukan sekadar kemampuan melayani lebih banyak permintaan halaman utama. Ketika promosi meningkatkan trafik, sesi permainan, pembayaran, verifikasi identitas, callback penyedia, dan rekonsiliasi dompet memiliki kebutuhan latensi dan konsistensi yang berbeda. Menambah instans aplikasi dapat mengurangi satu hambatan, tetapi menimbulkan hambatan baru pada database, gerbang pembayaran, atau penyimpanan sesi bersama. Keandalan mengajukan pertanyaan lain yang berkaitan: jika suatu dependensi gagal, mampukah platform menjaga keadaan akun dan transaksi tetap benar, memberikan informasi yang jelas, serta pulih sesuai sasaran terdokumentasi? Panduan ini menghubungkan perencanaan kapasitas dengan perjalanan pengguna kasino online, menjelaskan kegunaan dan batas redundansi, dan menyajikan matriks pengujian praktis. Dokumentasi vendor menerangkan teknik arsitektur, bukan bukti kemampuan atau tingkat layanan platform kasino tertentu. [1] [2] [3] [6]
Diterbitkan
Kapasitas yang andal berasal dari layanan terpisah, keadaan transaksi terlindungi, dan pemulihan teruji, bukan hanya jumlah server.
Daftar isi
Apa arti skalabilitas dan keandalan bagi platform kasino?
Skalabilitas berarti mempertahankan kualitas layanan saat permintaan berubah; keandalan berarti fungsi yang dimaksud terus berjalan dengan benar dan konsisten, termasuk pemulihan setelah gangguan. Platform dapat melayani lebih banyak tampilan halaman tetapi tetap gagal memeriksa saldo atau membuka permainan penyedia. Tentukan keberhasilan secara terpisah untuk penjelajahan, akses akun, permainan aktif, pembayaran, dan operasi back-office. [1] [2]
Kapasitas dan ketahanan berkaitan tetapi tidak sama. Server web tambahan tidak memperbaiki satu database dompet bersama yang gagal, sedangkan beberapa region tidak otomatis mencegah callback ganda. Identifikasi keadaan kritis, dependensi, dan batas waktu gangguan yang dapat diterima untuk setiap perjalanan pengguna sebelum memilih arsitektur. [1] [6]
Komponen mana yang menjadi hambatan saat trafik tinggi?
Satu permintaan dapat melewati edge, API aplikasi, layanan sesi, penyedia permainan, dompet, database, dan pipeline event. Masing-masing memiliki batas kapasitas sendiri. Uji beban perlu menelusuri perjalanan lengkap dan melaporkan waktu tunggu, kesalahan, serta saturasi setiap dependensi. Halaman depan yang cepat bukan bukti bahwa seluruh platform skalabel. [1] [5]
Komponen
Tanda tekanan
Yang perlu diuji
Edge dan lobi
Lonjakan kedatangan
Cache, kontrol laju, kapasitas origin
Login dan sesi
Login bersamaan
Penyimpanan identitas dan kelanjutan sesi
API pembukaan game
Respons penyedia
Timeout, kuota, token peluncuran
Dompet dan buku besar
Penulisan saldo serentak
Perebutan kunci dan rekonsiliasi
Pembayaran dan KYC
Layanan eksternal lambat
Antrean terbatas, status tertunda jelas
Event dan back-office
Penumpukan callback atau laporan
Lag konsumen dan pemutaran ulang
Pisahkan metrik puncak sesi bersamaan, transaksi per detik, dan batas laju tiap dependensi. Operator sebaiknya meminta data kapasitas terukur pada titik integrasi yang relevan, bukan menganggap angka pemasaran jumlah pemain sebagai jaminan laju transaksi. [1] [5]
Bagaimana menambah kapasitas aplikasi tanpa merusak sesi?
Worker web dan API yang stateless cocok untuk penskalaan horizontal di belakang load balancer dengan pemeriksaan kesehatan. Kubernetes mendokumentasikan penyesuaian replika otomatis melalui HorizontalPodAutoscaler, tetapi mekanisme itu bergantung pada metrik yang dipilih dan tidak menghilangkan hambatan database atau vendor. Pilih indikator yang mencerminkan antrean dan latensi pengguna sebenarnya. [3]
Simpan sesi akun dan keadaan kritis di luar worker aplikasi yang dapat diganti kapan saja.
Tetapkan permintaan sumber daya, batas replika aman, waktu pemanasan, dan batas laju berdasarkan pengujian nyata.
Terapkan backpressure ketika mitra pembayaran, permainan, atau verifikasi mendekati batas kontraknya.
Uji respons autoscaling terhadap lonjakan mendadak, pertumbuhan bertahap, dan penurunan skala.
Lobi, gerbang pembukaan permainan, dan worker asinkron mungkin memerlukan kebijakan kapasitas berbeda. Jika layanan hilir tidak dapat diskalakan, penolakan terkendali dengan pesan jelas lebih aman daripada pengulangan tanpa batas yang memperparah insiden. [1] [3]
Redundansi seperti apa yang melindungi perjalanan pemain aktif?
Redundansi mengatasi domain kegagalan: host, zona, jalur jaringan, atau penyedia eksternal dapat gagal secara independen. Sebarkan instans stateless kritis pada domain yang sesuai, gunakan health check yang benar-benar mengukur kesiapan layanan, dan tetapkan nasib permainan atau pembayaran yang sedang berjalan saat failover. Banyak instans bukan pengganti pengujian kepemilikan keadaan dan replay. [1] [6]
Petakan tiap perjalanan kritis ke komponen dan penyedia eksternal yang dibutuhkan.
Pisahkan beban agar penyedia lambat atau pekerjaan pelaporan tidak menghabiskan kapasitas bersama.
Tentukan health check, circuit breaker, batas timeout, dan fallback aman pada setiap batas layanan.
Latih kegagalan node, layanan, dan dependensi; bandingkan hasilnya dengan sasaran yang disepakati.
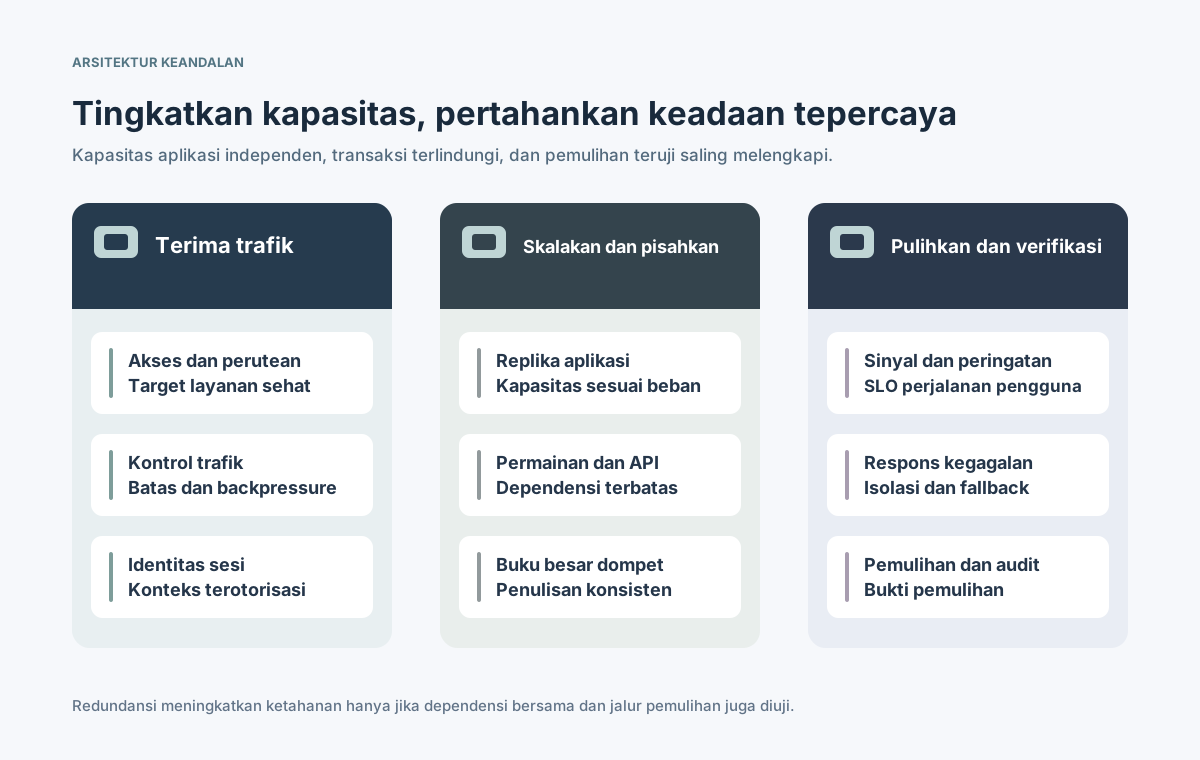
⊕Perbesar diagramRedundansi efektif memadukan perutean, kapasitas terisolasi, keadaan tepercaya, dan bukti pemulihan.
Failover dapat mempertahankan akses sambil membatasi fitur. Dokumentasikan operasi yang menjadi hanya-baca, dinonaktifkan, atau diantrekan saat gangguan sebagian; jangan menganggap keadaan keuangan aman hanya karena server aplikasi kedua masih merespons. [1] [6]
Mengapa sesi game dan transaksi dompet harus diskalakan berbeda?
Katalog game sering dapat memakai cache, tetapi saldo uang nyata dan hasil taruhan memerlukan urutan dan konsistensi yang otoritatif. Walaupun permintaan masuk melalui replika aplikasi berbeda, sistem transaksi operator harus mencegah dua tindakan serentak memakai dana yang sama atau mencatat hasil yang sama dua kali. Ini kebutuhan domain bisnis, bukan fitur autoscaling. [1] [4]
Operasi
Pola penskalaan aman
Syarat ketepatan
Menjelajahi game
Cache dengan masa berlaku terkontrol
Kelayakan pasar dan penyedia tetap mutakhir
Membuka game
Token terotorisasi berumur pendek
Satu konteks pemain dan game yang sah
Taruhan atau penyelesaian
Penulisan ledger berurutan/idempoten
Tidak ada debit atau settlement ganda
Membaca saldo
Nilai otoritatif dari server
Status penulisan tertunda dijelaskan
Memulihkan sesi
Validasi ulang dan rekonsiliasi
Tidak ada keadaan game atau dompet terabaikan
Lacak transaksi memakai ID permintaan, ID korelasi penyedia, entri ledger yang tahan lama, dan status akhir. Callback penyedia yang terlambat tidak boleh menimpa hasil baru yang telah dikonfirmasi; kontrak integrasi harus menjelaskan kapan rekonsiliasi atau tinjauan manual diperlukan. [4] [5]
Bagaimana antrean dan retry membantu tanpa menggandakan transaksi uang?
Antrean memisahkan pekerjaan, tetapi tidak menjamin urutan sempurna. AWS mendokumentasikan pengiriman setidaknya sekali dan kemungkinan urutan berbeda pada antrean SQS standar. Pelajarannya lebih luas: konsumen harus aman terhadap pesan ganda dan retry, bukan berasumsi bahwa satu callback pasti dieksekusi tepat satu kali. [4]
Berikan kunci idempotensi stabil pada operasi keuangan dan simpan hasil yang telah diproses secara tahan lama.
Batasi retry, gunakan jeda eksponensial, dan sediakan dead-letter queue atau jalur investigasi untuk event bermasalah.
Bedakan respons penyedia yang terlambat, hilang, atau saling bertentangan sebelum mengubah saldo.
Rekonsiliasi catatan penyedia dengan riwayat transaksi internal dan beri peringatan atas selisih yang belum selesai.
Perlakukan pemrosesan asinkron sebagai state machine dengan status tertunda, selesai, gagal, dan disengketakan yang dapat diamati. Idempotensi harus diterapkan pada batas penulisan otoritatif; kiriman antrean ganda perlu mengembalikan hasil lama, bukan membuat debit baru. [4] [7]
Keputusan database dan penyimpanan mana yang memengaruhi keandalan?
Replika baca dan cache dapat membantu pembacaan nonkritis, tetapi nilainya bisa tertinggal dari penulisan utama. Tentukan data yang membutuhkan konsistensi segera, yang boleh sedikit usang, dan yang harus bertahan saat zona atau region gagal. Partisi dan replikasi harus berdasarkan pola transaksi yang diukur serta uji kegagalan; menyalin database tidak otomatis mengamankan aplikasi. [1] [6]
Area data
Risiko umum
Bukti yang diminta
Buku besar dompet
Penulisan serentak dan durabilitas
Uji isolasi dan pemulihan
Identitas pemain
Pembatalan sesi
Perilaku logout lintas instans
Katalog game
Kesegaran cache
Propagasi perubahan pasar
Riwayat event
Replay dan jejak audit
Kebijakan urutan dan retensi
Cadangan data
Titik pemulihan yang dapat dipakai
Latihan restore dan pemeriksaan integritas
Cadangan, pemulihan ke titik waktu tertentu, dan rencana failover memerlukan pengujian terpisah. Sasaran titik pemulihan dan waktu pemulihan adalah keputusan bisnis yang eksplisit; backup yang belum pernah dipulihkan tidak membuktikan kemampuan memenuhi keduanya. [6]
Bagaimana operator mengukur keandalan dengan SLO dan telemetri?
Service-level indicator (SLI) mengukur pengalaman pengguna; service-level objective (SLO) menetapkan target yang dapat diterima. Google SRE menganjurkan indikator yang bermakna dan error budget alih-alih janji uptime sempurna tanpa definisi. Dalam operasi kasino, satu angka ketersediaan global dapat menyembunyikan kegagalan dompet atau pembukaan permainan. [2]
Tentukan indikator keberhasilan dan latensi terpisah untuk login, pembukaan game, penulisan dompet, dan pembayaran.
Pantau trafik, tingkat kesalahan, latensi, dan saturasi pada edge serta layanan hilir.
Korelasikan trace, metrik, dan log lintas panggilan API, antrean, dan penyedia memakai identitas yang aman.
Beri peringatan atas dampak pada pengguna, settlement tertahan, dan keterlambatan rekonsiliasi; tetapkan penanggung jawab dan runbook.
OpenTelemetry mendokumentasikan sinyal telemetri, sementara panduan pemantauan Google menjelaskan empat sinyal utama. Jangan mengekspor data sensitif pemain atau pembayaran hanya demi observabilitas; batasi akses dan masa simpan data diagnostik. [5] [7]
Apa yang harus ada dalam disaster recovery dan deployment aman?
Ketersediaan saat satu komponen gagal berbeda dengan pemulihan bencana setelah peristiwa besar. Tentukan recovery time objective (RTO) dan recovery point objective (RPO) bagi perjalanan dan data kritis, lalu pilih strategi yang benar-benar bisa memenuhinya. AWS menjelaskan keduanya sebagai sasaran terukur, bukan angka universal yang otomatis dicapai tiap platform. [6]
Simpan backup berversi yang dapat dipulihkan dan verifikasi integritasnya melalui latihan terkendali.
Dokumentasikan infrastruktur, rahasia akses, dependensi, dan personel yang dibutuhkan untuk pemulihan.
Gunakan rilis bertahap, health gate, rollback, dan pemeriksaan kompatibilitas sesi aktif.
Uji hilangnya zona atau dependensi inti sambil melindungi transaksi dompet dari replay ambigu.
Komunikasikan status layanan parsial dan langkah berikutnya kepada pemain serta tim dukungan.
Runbook yang matang mencatat pemilik insiden, keputusan menghentikan transaksi baru, urutan pemulihan, dan rekonsiliasi setelah insiden. Uji ulang setelah perubahan besar; sekadar mengetahui perintah backup bukan rencana pemulihan produksi. [1] [6]
Apa yang perlu diuji tim sebelum menyetujui platform?
Uji penerimaan perlu menggabungkan trafik representatif, gangguan terkontrol, dan pemeriksaan konsistensi keuangan. Minta metodologi uji beban, batas dependensi, peringatan, jalur eskalasi insiden, serta bukti pemulihan. Angka benchmark dari arsitektur, pasar, atau campuran penyedia lain bukan jaminan mengikat. [1] [2]
Jalankan uji puncak dan lonjakan dengan kombinasi login, lobi, game, dan dompet yang realistis, bukan satu endpoint sintetis.
Verifikasi tidak terjadi debit ganda, settlement hilang, atau pertumbuhan antrean tanpa batas selama retry dan failover.
Ukur SLO, RTO, RPO, dan status yang dilihat pengguna saat rilis bertahap serta latihan pemulihan.
Catat ambang penerimaan, pemilik sistem, dependensi vendor, dan risiko tersisa sebelum persetujuan.
Sasarannya bukan jumlah server maksimum atau klaim uptime tanpa syarat. Platform harus tumbuh sambil membuktikan saldo benar, hasil pengguna dapat diprediksi, dan pemulihan telah diuji untuk perjalanan yang benar-benar ditawarkan operator. [1] [4] [6]