Évolutivité et fiabilité d'une plateforme de casino
L'évolutivité d'une plateforme de casino ne se mesure pas seulement à la rapidité d'affichage de sa page d'accueil. Une promotion peut augmenter simultanément les connexions, les sessions de jeu, les appels aux fournisseurs, les opérations de portefeuille et les notifications techniques. Chaque parcours impose des exigences différentes en matière de latence et de cohérence. Ajouter des serveurs applicatifs peut soulager l'API tout en saturant une base de données commune, un prestataire de paiement ou un service de sessions. La fiabilité pose une autre question : en cas de panne, les soldes et les transactions restent-ils exacts, les joueurs comprennent-ils la situation et la reprise respecte-t-elle les objectifs convenus ? Nous relions la capacité aux parcours réels d'un casino, distinguons les avantages et les limites de la redondance et proposons une grille de recette. Les documents des fournisseurs techniques ne prouvent ni les performances ni les engagements contractuels d'une plateforme précise. [1] [2] [3] [6]
Publié le
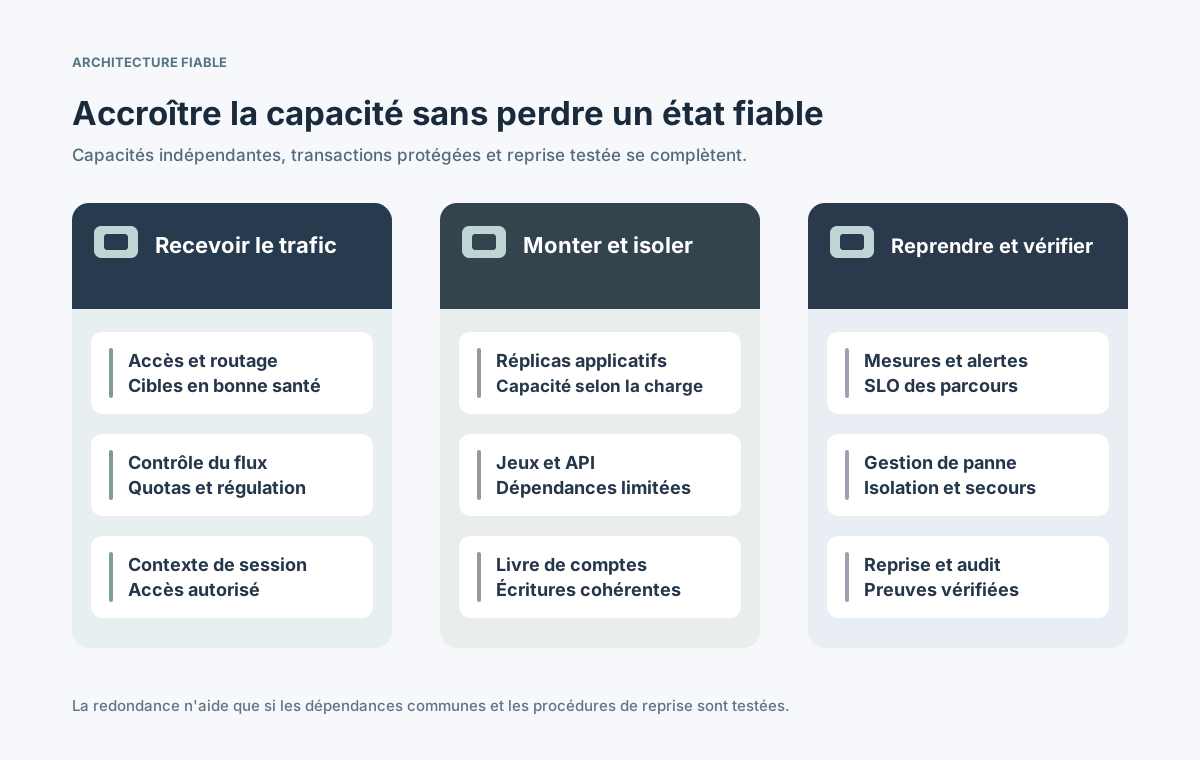
La fiabilité dépend de services indépendants, d'un état protégé et d'une reprise éprouvée, pas du seul nombre de serveurs.
Sommaire
Que signifient évolutivité et fiabilité pour un casino en ligne ?
L'évolutivité consiste à maintenir un service acceptable lorsque la demande varie. La fiabilité consiste à exécuter correctement et durablement les fonctions attendues, y compris après une panne. Un catalogue rapide ne compense pas l'échec d'une consultation de solde ou d'un lancement de jeu. Évaluez séparément la connexion, la navigation, le jeu actif, les paiements et l'administration. [1] [2]
La capacité et la résilience sont liées, mais distinctes. Plusieurs serveurs web ne réparent pas une base de portefeuille unique en panne, et plusieurs régions n'empêchent pas automatiquement un callback en double. Définissez les données critiques, les dépendances et les interruptions tolérables par parcours avant de choisir les technologies. [1] [6]
Quels composants saturent d'abord lorsque le trafic augmente ?
Une action peut solliciter l'entrée réseau, l'API, les sessions, le fournisseur de jeu, le portefeuille, la base et le traitement d'événements. Chaque élément a un plafond de capacité. Les tests doivent reproduire le parcours complet et mesurer attente, erreurs et saturation par dépendance. Une page d'accueil rapide ne prouve pas la capacité transactionnelle. [1] [5]
Composant
Signe de pression
Contrôle à effectuer
Entrée et lobby
Arrivées soudaines
Cache, limitation, origine
Connexion et session
Connexions simultanées
Stockage et continuité
API de lancement
Attente fournisseur
Délais, quotas et jetons
Portefeuille
Écritures concurrentes
Verrous et rapprochement
Paiement et KYC
Service tiers lent
Files et état en attente
Événements et rapports
Retard des callbacks
Retard et rejouabilité
Ne confondez pas sessions simultanées, transactions par seconde et limites des fournisseurs. Demandez des mesures par point d'intégration plutôt que de transformer un nombre marketing d'utilisateurs en garantie de débit financier. [1] [5]
Comment augmenter la capacité applicative sans rompre les sessions ?
Les services web et API sans état se prêtent à une augmentation horizontale derrière un répartiteur vérifiant leur état. Kubernetes documente l'ajustement automatique des réplicas via HorizontalPodAutoscaler, mais cela dépend des métriques retenues et ne supprime pas les goulets d'étranglement des bases ou des partenaires. Choisissez des mesures reflétant attente et latence réellement subies. [3]
Conserver les sessions et états critiques hors des processus applicatifs remplaçables.
Fixer demandes de ressources, limites de réplicas et temps de démarrage après mesures réelles.
Réguler les requêtes quand les quotas des jeux, paiements ou vérifications approchent.
Tester l'ajustement lors d'un pic brutal, d'une montée progressive et de la baisse de charge.
Lobby, passerelle de jeu et traitements différés peuvent nécessiter des politiques distinctes. Lorsqu'une dépendance ne suit plus, un refus maîtrisé et explicite est plus sûr que des tentatives illimitées qui aggravent l'incident. [1] [3]
Quelle redondance protège un parcours de jeu en cours ?
La redondance doit couvrir des domaines de panne : hôte, zone, trajet réseau ou fournisseur externe. Répartissez les instances critiques, vérifiez leur disponibilité réelle et définissez le devenir d'un jeu ou d'un paiement non terminé lors du basculement. Plusieurs copies du code ne remplacent pas le contrôle des états et des rejouements. [1] [6]
Relier chaque parcours critique à ses composants et partenaires indispensables.
Isoler les charges pour qu'un fournisseur lent ou un rapport lourd n'épuise pas le système.
Définir contrôles de santé, coupe-circuits, délais maximums et solution de repli sûre.
Simuler la perte d'un nœud, d'un service et d'un partenaire puis mesurer l'écart aux objectifs.
⊕Agrandir le schémaLa redondance efficace associe routage, capacité isolée, états fiables et preuves de reprise.
Un basculement peut maintenir une partie des fonctions tout en limitant les autres. Précisez les opérations seulement consultables, bloquées ou mises en attente. La réponse d'un second serveur ne garantit pas l'intégrité financière. [1] [6]
Pourquoi les jeux et les portefeuilles ne se dimensionnent-ils pas pareil ?
Le catalogue de jeux tolère souvent la mise en cache, mais un solde en argent réel et le résultat d'une mise exigent un ordre et une cohérence faisant autorité. Même lorsque les requêtes atteignent différents réplicas, le système transactionnel doit empêcher deux débits ou deux validations du même résultat. Ce n'est pas une fonctionnalité de l'autoscaling. [1] [4]
Opération
Approche sûre
Condition de validité
Recherche de jeux
Cache avec expiration
Éligibilité du marché à jour
Lancement de jeu
Jeton autorisé temporaire
Bon joueur et bonne partie
Mise et règlement
Écriture idempotente
Ni double débit ni double règlement
Lecture du solde
Valeur du serveur
Écritures en attente visibles
Retour de session
Revérification et rapprochement
Pas d'opération orpheline
Reliez identifiant de requête, référence du fournisseur, écriture durable et état final. Un callback tardif ne doit pas écraser un résultat plus récent et confirmé ; le contrat définit le rapprochement ou l'examen manuel. [4] [5]
Comment les files et les reprises évitent-elles les mouvements d'argent en double ?
Les files découplent les traitements sans garantir un ordre parfait. AWS documente la livraison au moins une fois et l'arrivée possible hors séquence des messages SQS standard. Cette caractéristique illustre une règle générale : les consommateurs doivent supporter doublons et nouvelles tentatives de callback. [4]
Associer une clé d'idempotence stable à chaque opération financière et enregistrer son résultat.
Limiter les reprises, appliquer une attente croissante et prévoir une file d'investigation.
Distinguer réponses du partenaire tardives, absentes ou contradictoires avant toute écriture.
Rapprocher les relevés du fournisseur du livre interne et signaler les différences non résolues.
Un traitement asynchrone doit présenter les états attente, terminé, échec et litige. L'idempotence se vérifie au point d'écriture autoritatif : un message répété renvoie le premier résultat sans nouveau débit. [4] [7]
Quels choix de stockage influencent directement la fiabilité ?
Les réplicas de lecture et les caches peuvent accélérer les demandes non critiques mais afficher des valeurs en retard. Déterminez les données exigeant une cohérence immédiate, celles tolérant un décalage et celles devant survivre à une perte de zone ou de région. Réplication et partitionnement doivent être validés par les charges et pannes observées. [1] [6]
Données
Risque habituel
Preuve à demander
Livre du portefeuille
Écritures concurrentes
Isolation et exercice de reprise
Identité des joueurs
Révocation des sessions
Déconnexion sur toutes les instances
Catalogue de jeux
Cache périmé
Propagation d'un changement de marché
Journal d'événements
Rejeu et audit
Ordre et conservation
Sauvegardes
Point de reprise exploitable
Restauration et intégrité
Sauvegardes, restauration à un instant donné et basculement sont trois vérifications différentes. RPO et RTO relèvent de décisions métier : une copie jamais restaurée ne prouve pas que les objectifs sont réalisables. [6]
Comment mesurer la fiabilité avec SLO et télémétrie ?
Un indicateur SLI décrit un résultat observable ; un objectif SLO fixe son niveau acceptable. Google SRE privilégie des indicateurs représentatifs et des budgets d'erreur plutôt qu'une promesse vague de disponibilité totale. Une seule mesure de disponibilité peut masquer des défaillances de portefeuille ou de lancement de jeu. [2]
Mesurer séparément réussite et latence des connexions, lancements, écritures et paiements.
Suivre trafic, erreurs, délai et saturation à l'entrée comme chez les partenaires.
Corréler traces, métriques et journaux entre API, files et fournisseurs avec des références sûres.
Alerter sur l'impact utilisateur, les règlements bloqués et le retard de rapprochement ; nommer les responsables.
OpenTelemetry décrit les signaux de télémétrie, tandis que Google détaille les quatre signaux essentiels. Évitez d'exposer des données personnelles ou financières dans les journaux : contrôlez accès et durée de conservation. [5] [7]
Que doivent couvrir la reprise après sinistre et les mises en production ?
Maintenir le service après la panne d'un composant et reprendre après un incident majeur sont deux capacités distinctes. Fixez le délai de reprise RTO et la perte de données admissible RPO pour chaque parcours critique, puis choisissez une stratégie démontrable. AWS présente ces valeurs comme des objectifs de récupération, pas comme des chiffres universellement garantis. [6]
Conserver des sauvegardes versionnées et vérifier leur restauration et leur intégrité.
Documenter infrastructure, secrets, dépendances et personnes nécessaires à la reprise.
Déployer par étapes avec contrôles de santé, retour arrière et compatibilité des sessions.
Tester la perte d'une zone ou d'un service sans rejouer des débits ambigus.
Indiquer aux joueurs et à l'assistance les restrictions temporaires et la marche à suivre.
La procédure d'incident précise qui décide, quand suspendre de nouvelles opérations, comment restaurer et comment rapprocher les transactions ensuite. Rejouez ces exercices après chaque modification majeure. [1] [6]
Quels essais exiger avant l'acceptation d'une plateforme ?
La recette doit associer trafic réaliste, pannes ciblées et exactitude des résultats financiers. Demandez la méthode de charge, les quotas des partenaires, les alertes, l'escalade et des preuves de récupération. Un benchmark réalisé sur une autre infrastructure ou un autre marché ne vaut pas garantie contractuelle. [1] [2]
Tester pics et rafales avec un mélange crédible de connexions, jeux, navigation et portefeuille.
Provoquer délais fournisseurs, callbacks perdus ou répétés et saturation passagère de la base.
Vérifier l'absence de double débit, règlement perdu ou file qui grossit sans limite.
Mesurer SLO, RTO, RPO et messages visibles pendant déploiement et reprise.
Consigner seuils de recette, responsables, dépendances externes et risques résiduels.
L'objectif n'est ni la plus grande flotte de serveurs ni un taux publicitaire de disponibilité. C'est un service capable de grandir tout en prouvant la justesse des soldes, la prévisibilité des opérations et une reprise testée. [1] [4] [6]