Escalabilidad y Confiabilidad de Plataformas de Casino
La escalabilidad de una plataforma de casino no consiste únicamente en servir más visitas a la página principal. Una promoción puede aumentar al mismo tiempo los inicios de sesión, las partidas, las llamadas a proveedores, los movimientos de billetera y los callbacks. Cada proceso tiene necesidades distintas de latencia y consistencia. Agregar servidores de aplicación puede mejorar la API y a la vez saturar una base compartida, una pasarela de pagos o el sistema de sesiones. La confiabilidad plantea otra pregunta: si falla una dependencia, ¿seguirán siendo correctos los saldos y las transacciones, habrá información clara para los usuarios y se cumplirá el objetivo de recuperación? Esta guía relaciona la capacidad con recorridos reales de casino, explica los límites de la redundancia y propone una matriz de validación. Los documentos técnicos describen prácticas generales y no prueban el desempeño ni los SLA de una plataforma comercial específica. [1] [2] [3] [6]
Publicado
La capacidad confiable surge de servicios independientes, datos protegidos y recuperación ensayada, no solo de más servidores.
Contenido
¿Qué significan escalabilidad y confiabilidad en una plataforma de casino?
Escalabilidad es mantener un servicio aceptable cuando cambia la demanda; confiabilidad es ejecutar correctamente las funciones de forma constante, incluso al recuperarse de una falla. Un catálogo puede funcionar rápido mientras falla la consulta de saldo o el lanzamiento de una partida. Establece objetivos separados para exploración, inicio de sesión, juego activo, pagos y backoffice. [1] [2]
Capacidad y resiliencia están relacionadas, pero no son equivalentes. Más servidores web no reparan una base única de billetera; varias regiones tampoco eliminan por sí solas los callbacks duplicados. Identifica estado crítico, dependencias y tiempo de interrupción tolerable por recorrido antes de elegir arquitectura. [1] [6]
¿Qué componentes se saturan primero cuando crece el tráfico?
Una solicitud puede pasar por el borde, la API, las sesiones, el proveedor de juegos, la billetera, la base y la cola de eventos. Cada dependencia tiene un límite propio. Las pruebas de carga deben cubrir recorridos completos y medir espera, errores y saturación por componente. Una página principal veloz no demuestra escalabilidad transaccional. [1] [5]
Componente
Señal de presión
Qué verificar
Acceso y lobby
Llegadas repentinas
Caché, control de tasa, origen
Login y sesión
Accesos simultáneos
Almacén y continuidad
API de lanzamiento
Latencia del proveedor
Timeout, cuotas y tokens
Billetera y libro
Escrituras concurrentes
Bloqueos y conciliación
Pagos y KYC
Servicios externos lentos
Colas y estados pendientes
Eventos e informes
Callbacks acumulados
Retraso y reproceso
No confundas sesiones concurrentes, transacciones por segundo y cuotas de socios. Pide capacidad medida en los puntos reales de integración en vez de convertir un número promocional de usuarios en garantía de procesamiento financiero. [1] [5]
¿Cómo aumentar la capacidad de la aplicación sin interrumpir las sesiones?
Los servicios web y API sin estado pueden escalar horizontalmente detrás de un balanceador con verificaciones de salud. Kubernetes documenta el HorizontalPodAutoscaler para ajustar réplicas según métricas, pero esto no elimina los cuellos de botella de bases ni las cuotas de proveedores. Elige métricas relacionadas con la fila y la latencia que enfrenta el usuario. [3]
Guardar sesiones y estado crítico fuera de procesos de aplicación reemplazables.
Definir recursos, límites de réplicas y tiempo de arranque con resultados de pruebas.
Aplicar control de presión cuando los socios de juegos, pagos o verificación lleguen a sus cuotas.
Probar la respuesta del escalado ante ráfagas, crecimiento progresivo y reducción de carga.
El lobby, la pasarela de juegos y los procesos asíncronos pueden requerir políticas distintas. Si un socio no puede atender más solicitudes, un rechazo controlado y claro es preferible a reintentos infinitos que agravan el problema. [1] [3]
¿Qué tipo de redundancia protege una sesión de juego activa?
La redundancia debe considerar dominios de falla: servidor, zona, red o proveedor externo pueden dejar de funcionar por separado. Distribuye instancias críticas, verifica su preparación real y define qué pasará con partidas o pagos sin concluir durante una conmutación. Tener varios servidores no sustituye las pruebas de estados y reprocesos. [1] [6]
Relacionar cada recorrido crítico con los servicios y socios que efectivamente necesita.
Aislar cargas para que un proveedor lento o informe pesado no agote recursos comunes.
Definir health checks, circuit breakers, tiempos límite y alternativas seguras.
Simular la caída de un nodo, un servicio y un socio y comparar el resultado con el objetivo.
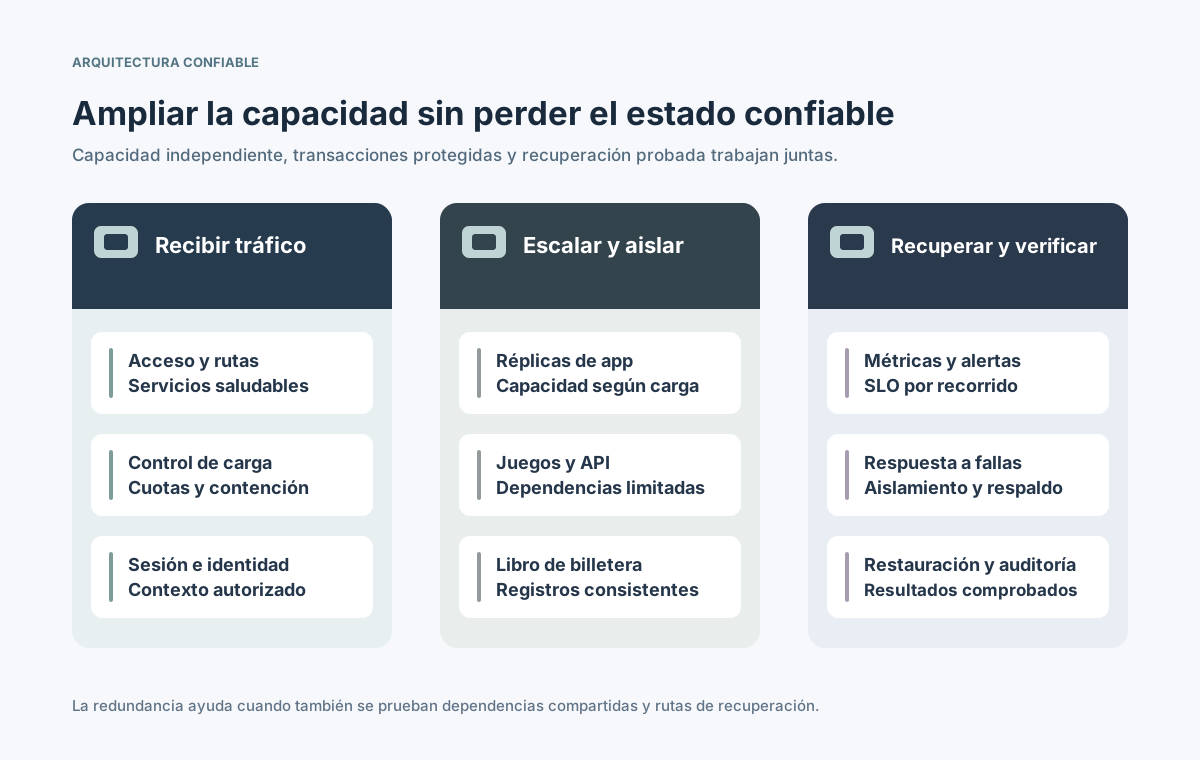
⊕Ampliar diagramaLa redundancia eficaz combina ruteo, capacidad aislada, estado confiable y evidencia de recuperación.
La conmutación puede mantener algunas funciones y restringir otras. Documenta cuáles quedan solo de lectura, bloqueadas o en espera. Una segunda API que responde no demuestra automáticamente integridad de las operaciones con dinero. [1] [6]
¿Por qué las partidas y las operaciones de billetera escalan de modo diferente?
El catálogo puede tolerar caché, pero un saldo en dinero real y el resultado de una apuesta requieren orden y consistencia autoritativos. Aunque las solicitudes lleguen a réplicas diferentes, el sistema transaccional debe impedir gastar dos veces los mismos fondos o registrar repetidamente el mismo resultado. No es una función del autoscaling. [1] [4]
Operación
Patrón seguro
Condición correcta
Buscar juegos
Caché con vencimiento
Elegibilidad por mercado actualizada
Abrir juego
Token autorizado breve
Jugador y contexto válidos
Apuesta y liquidación
Escritura idempotente
Sin cargo o liquidación duplicados
Consultar saldo
Valor del servidor
Pendientes explicados
Retomar sesión
Validar y conciliar
Sin partidas huérfanas
Relaciona identificador de solicitud, referencia del proveedor, asiento durable y estado final. Un callback tardío no debe reemplazar un resultado confirmado más reciente; el contrato debe establecer conciliación o revisión manual. [4] [5]
¿Cómo usar colas y reintentos sin duplicar movimientos de dinero?
Las colas desacoplan tareas, pero no garantizan una secuencia perfecta. AWS documenta entrega al menos una vez y posibles mensajes fuera de orden en SQS estándar. La enseñanza general es diseñar consumidores que toleren callbacks repetidos y entregas duplicadas. [4]
Asignar claves estables de idempotencia a movimientos financieros y guardar los resultados.
Limitar reintentos, aplicar espera creciente y crear una ruta de investigación para eventos difíciles.
Distinguir respuestas del socio tardías, ausentes o contradictorias antes de cambiar la billetera.
Conciliar registros externos con transacciones internas y alertar por diferencias abiertas.
El trabajo asíncrono necesita estados visibles: pendiente, completo, fallido y en disputa. La idempotencia debe aplicarse donde se escribe el asiento final; una segunda entrega devuelve el resultado previo sin generar otro cargo. [4] [7]
¿Qué decisiones de datos y almacenamiento afectan la confiabilidad?
Las réplicas de lectura y la caché agilizan consultas no críticas, pero pueden atrasarse respecto a las escrituras. Distingue qué datos requieren consistencia inmediata, cuáles toleran desfase y cuáles deben sobrevivir a la caída de una zona o región. La replicación o partición debe responder a patrones medidos y pruebas de falla. [1] [6]
Datos
Riesgo habitual
Evidencia necesaria
Libro de billetera
Escrituras simultáneas
Aislamiento y restauración
Identidad
Revocación de sesión
Cierre en todas las réplicas
Catálogo
Caché vieja
Propagación de cambios de mercado
Historial de eventos
Reprocesos y auditoría
Orden y retención
Respaldos
Punto recuperable
Simulacro de restauración e integridad
Prueba por separado respaldos, restauración a un momento específico y conmutación. RPO y RTO son metas del negocio; una copia jamás restaurada no demuestra que puedan cumplirse. [6]
¿Cómo medir confiabilidad con SLO y telemetría?
Un indicador SLI mide lo que vive el usuario; el objetivo SLO define el nivel aceptable. Google SRE recomienda indicadores relevantes y presupuestos de error en lugar de prometer disponibilidad perfecta sin definición. Una sola cifra global puede ocultar errores de billetera o lanzamiento. [2]
Definir éxito y latencia específicos para login, apertura de juegos, billetera y pagos.
Medir tráfico, errores, latencia y saturación en el borde y todas las dependencias.
Relacionar trazas, métricas y logs de API, colas y proveedores mediante identificadores seguros.
Alertar por impacto al jugador, liquidaciones pendientes y demora de conciliación, con responsables claros.
OpenTelemetry documenta señales de telemetría y Google describe las cuatro señales clave. No expongas datos privados ni información de pagos en logs de diagnóstico: limita el acceso y la retención. [5] [7]
¿Qué deben incluir la recuperación de desastres y los despliegues seguros?
Conservar el servicio cuando falla un componente y recuperarse de un incidente mayor son capacidades diferentes. Define tiempo objetivo de recuperación RTO y pérdida de datos permitida RPO para las funciones críticas, y elige una estrategia comprobable. AWS los presenta como objetivos medibles, no como garantías universales. [6]
Conservar respaldos versionados y verificar restauración e integridad en ensayos.
Documentar infraestructura, secretos, dependencias y personas necesarias para recuperar.
Publicar cambios por etapas con controles de salud, reversión y compatibilidad de sesiones.
Probar caída de zona o servicio sin repetir movimientos ambiguos de billetera.
Explicar a jugadores y soporte los estados de servicio parcial y siguientes pasos.
Un procedimiento debe indicar quién dirige el incidente, cuándo detener transacciones nuevas, cómo restaurar y cómo conciliar después. Repite el ejercicio tras cambios importantes: conocer el comando de respaldo no constituye un plan. [1] [6]
¿Qué pruebas deben aprobarse antes de aceptar una plataforma?
La aceptación debe combinar tráfico representativo, fallas específicas y verificación de resultados financieros. Solicita metodología de carga, cuotas externas, alertas, escalamiento y pruebas de recuperación. Un benchmark de otra infraestructura o mercado no representa una garantía contractual. [1] [2]
Probar picos con mezcla realista de inicios, lobby, juegos y movimientos de billetera.
Provocar timeout de socios, callbacks perdidos o duplicados y saturación temporal de la base.
Confirmar ausencia de cargos dobles, liquidaciones extraviadas y colas sin límite.
Medir SLO, RTO, RPO y mensajes visibles al usuario durante despliegue y recuperación.
Documentar umbrales de aceptación, responsables, dependencias y riesgos pendientes.
La meta no es tener más servidores ni anunciar un porcentaje genérico de uptime: es crecer con saldos correctos, resultados previsibles y recuperación demostrada de los recorridos realmente ofrecidos. [1] [4] [6]